Transformando dados de produto em entendimento do usuário, sem alucinações.
Problema
Eu conheci vários times de produto que tentam fazer pesquisa. Eles até fazem, mas o resto do time acaba ignorando os resultados. Não porque eles não querem usar, mas porque nem conseguem conectar o que descobriram com as decisões do dia a dia. A persona fica num arquivo no Figma ou num PPT. As transcrições de entrevistas vivem num doc do Notion que nem mesmo a pessoa que participou da entrevista volta pra revisitar.
Então eu vi que o gap não era esforço, era a forma que esses dados chegavam pro time. Por isso eu construí o Resense: para ajudar times de produto a extrair valor do que eles já tinham em casa, sem precisar de especialista pra interpretar e nem precisar gastar horas em artefatos de persona que vão pra última gaveta.
A stack de IA
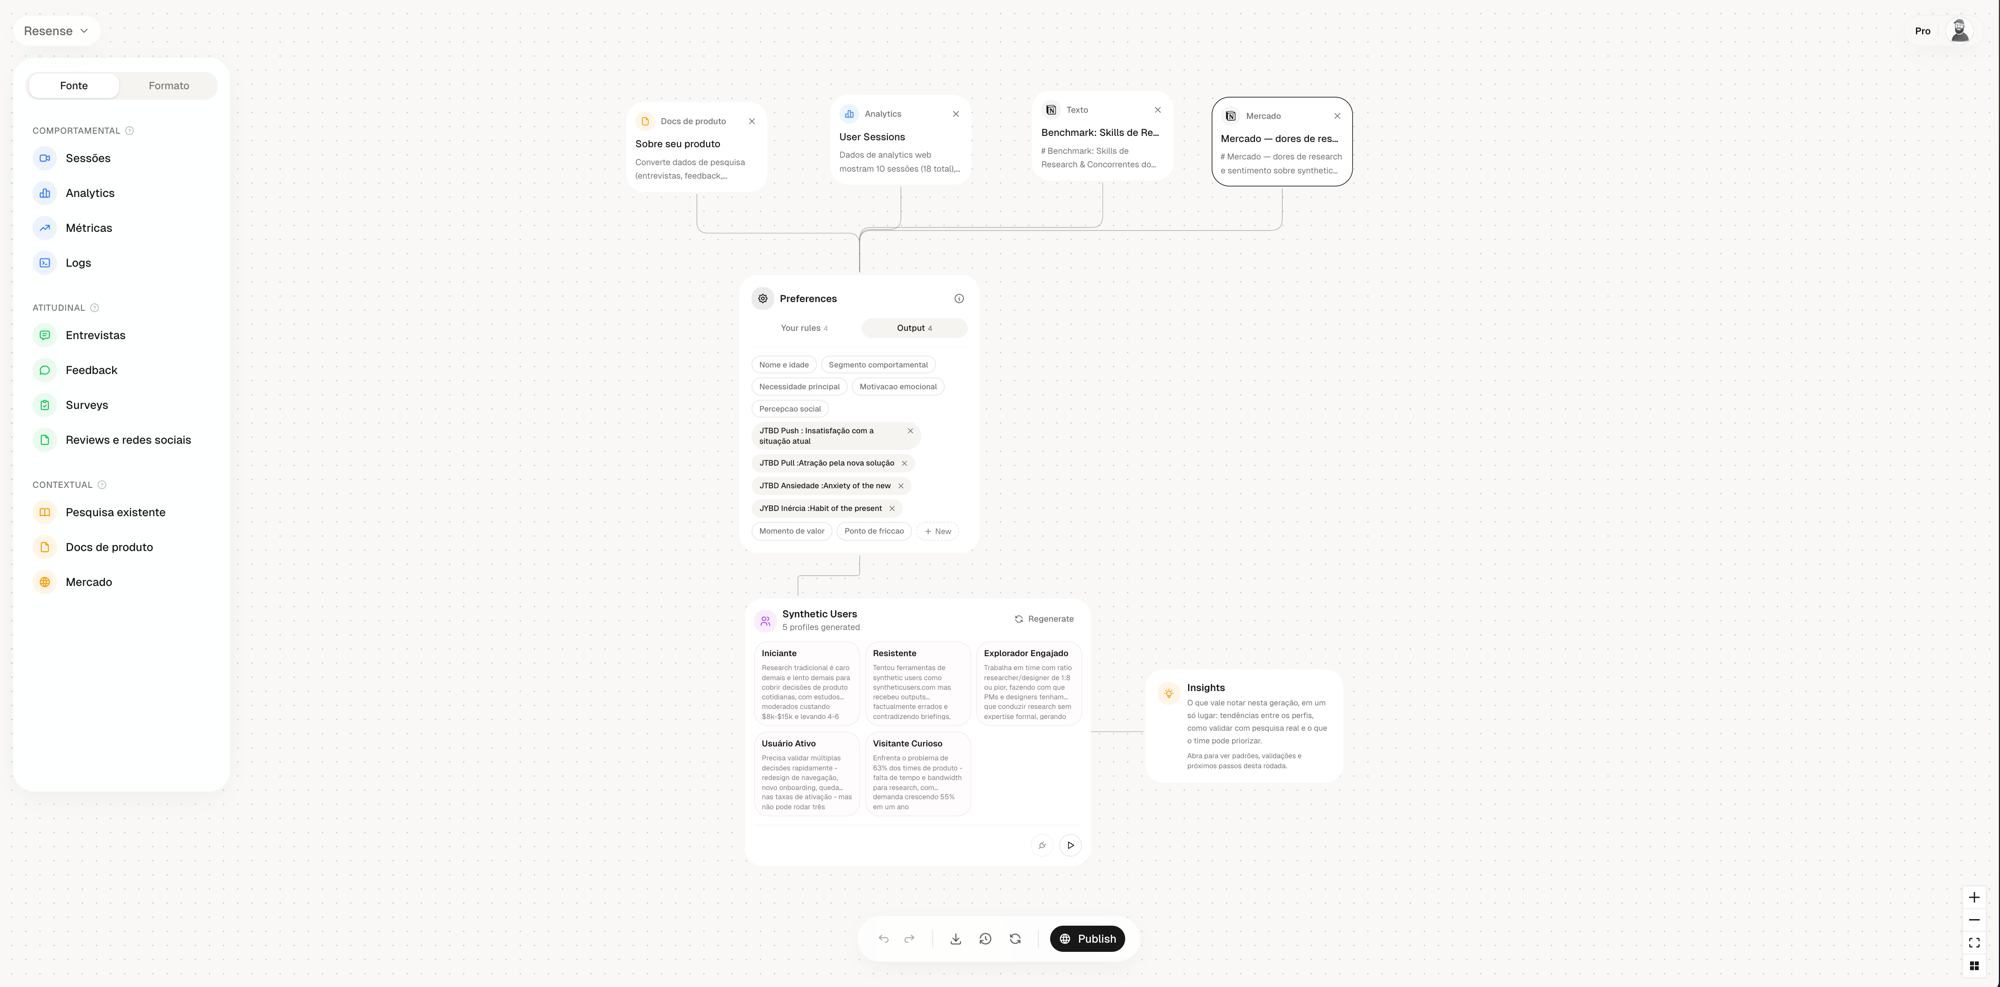
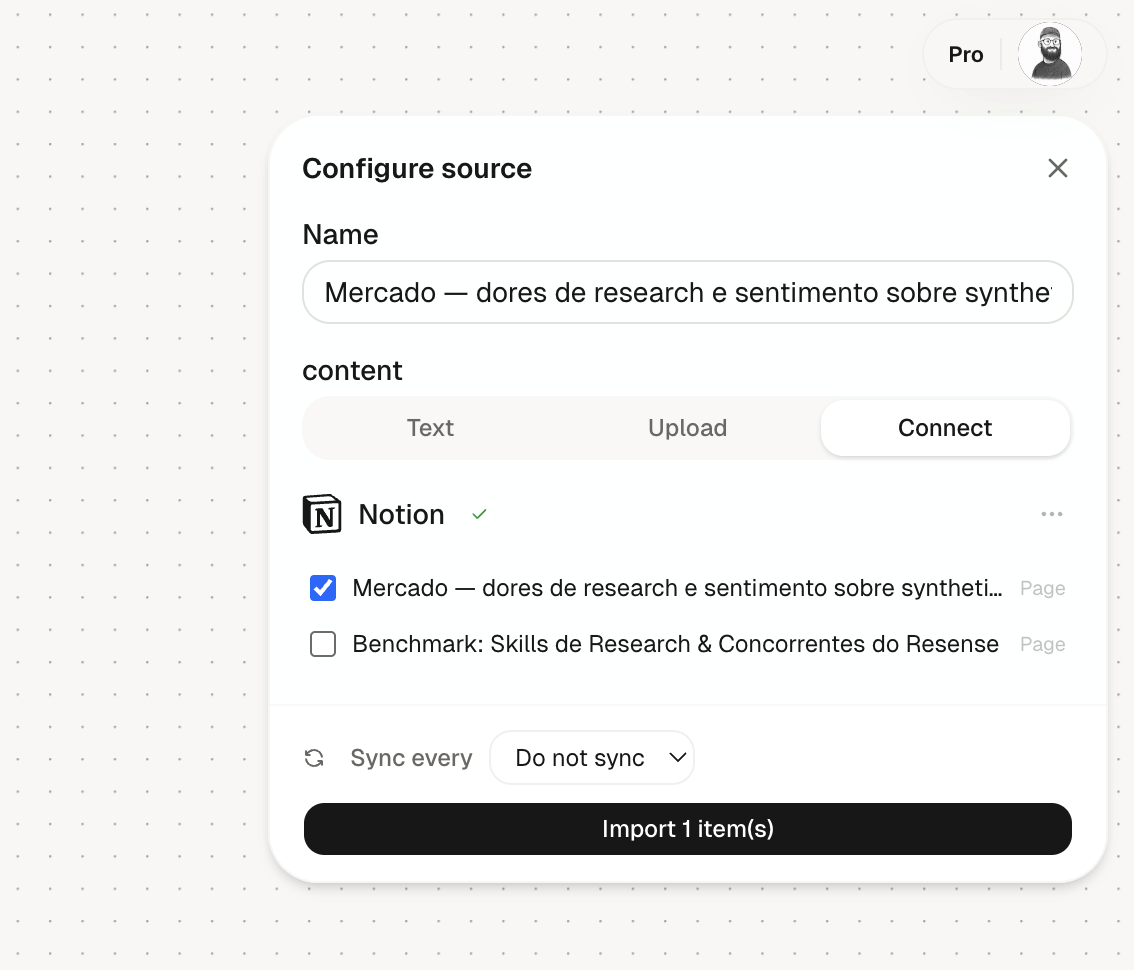
O pipeline de geração mapeia dados brutos de produto por JTBD e guardrails anti-otimismo, estruturando em Synthetic Users via OpenRouter com Claude Sonnet em produção e Gemini Flash em desenvolvimento. Eu cheguei nessa estratégia de dois modelos testando: iteração em dev precisava de velocidade, produção precisava de qualidade de raciocínio para síntese complexa. Servem jobs diferentes.
A avaliação com RAG recupera chunks de fonte relevantes para ancorar a análise em dados reais de usuário. É isso que faz o time de produto confiar no output: cada insight rastreia de volta a uma fonte.
O prompt cache faz duas coisas: reduz custo de token e corta a latência de resposta em 63%. Numa ferramenta de pesquisa onde a gente está esperando uma síntese antes de uma reunião, essa diferença de velocidade importa tanto quanto o conteúdo em si.
Cada requisição passa por uma camada BYOK para o free tier: o usuário traz a própria chave de API (OpenRouter, Anthropic, OpenAI ou Google), que nunca sai do browser. Auto-detecção roteia para o provedor certo. O servidor nunca armazena nem loga as chaves de convidados.
As decisões de design
Calibrar confiança foi o problema de design mais difícil. LLMs parecem autoritativos mesmo quando estão chutando, então o maior risco do produto era entregar outputs que o time usaria sem questionar. Eu cheguei em três sistemas que atacam isso de frente.
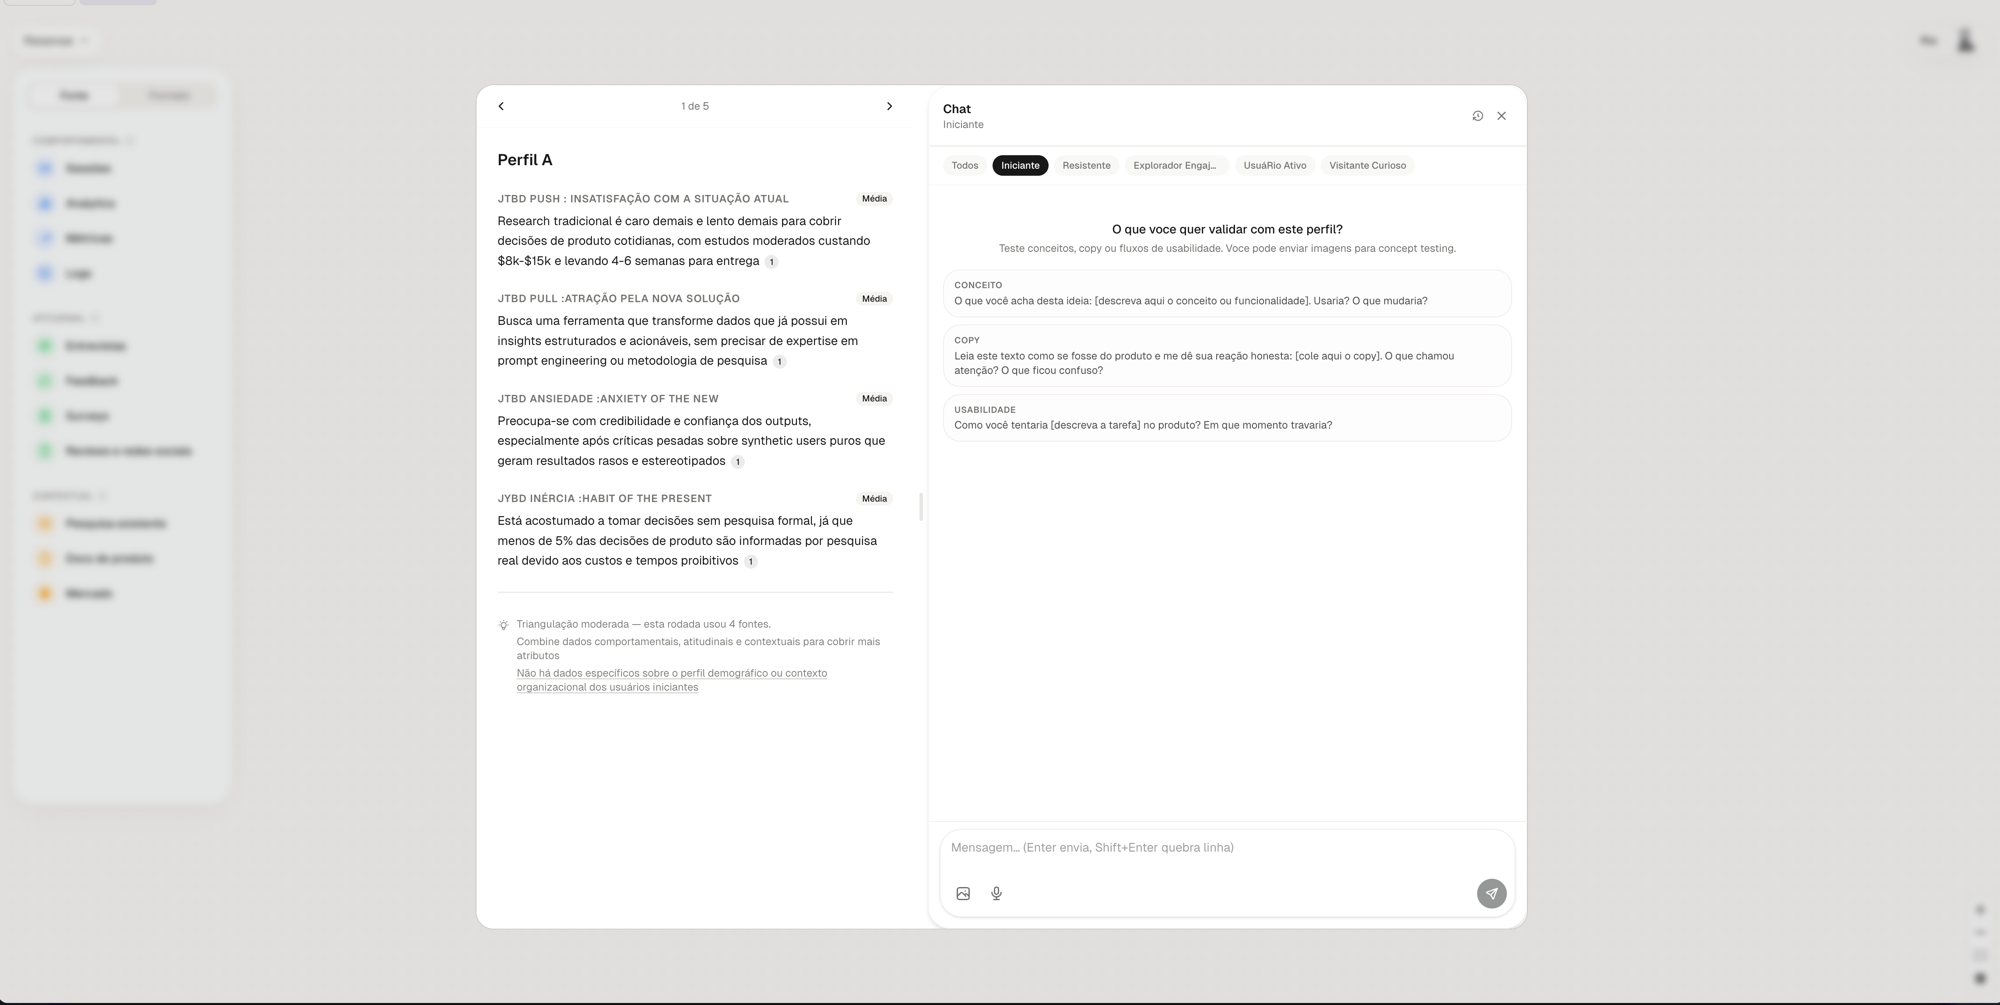
Citações de fonte por atributo: todo insight num perfil Synthetic User linka de volta pra fonte de onde veio. Campos inferidos são marcados com [Inferido] no output. O usuário vê exatamente o que veio dos dados e o que foi inferência do modelo.
O guardrail anti-otimismo é uma lista de proibições no system prompt: quatro padrões que invalidam uma geração. A camada força o modelo a descrever pontos de fricção como situações específicas, quando, onde, o que acontece. Se o ponto de fricção for vago, a geração falha na validação.
O triangulation score mede diversidade de fontes (comportamental, atitudinal, contextual) com multiplicador: um tipo de fonte rende 0.6x de confiança, três tipos rendem 1.0x. O ConfidenceBadge renderiza como aviso, informação ou confirmação, e mostra exatamente quais tipos de fonte estão faltando.
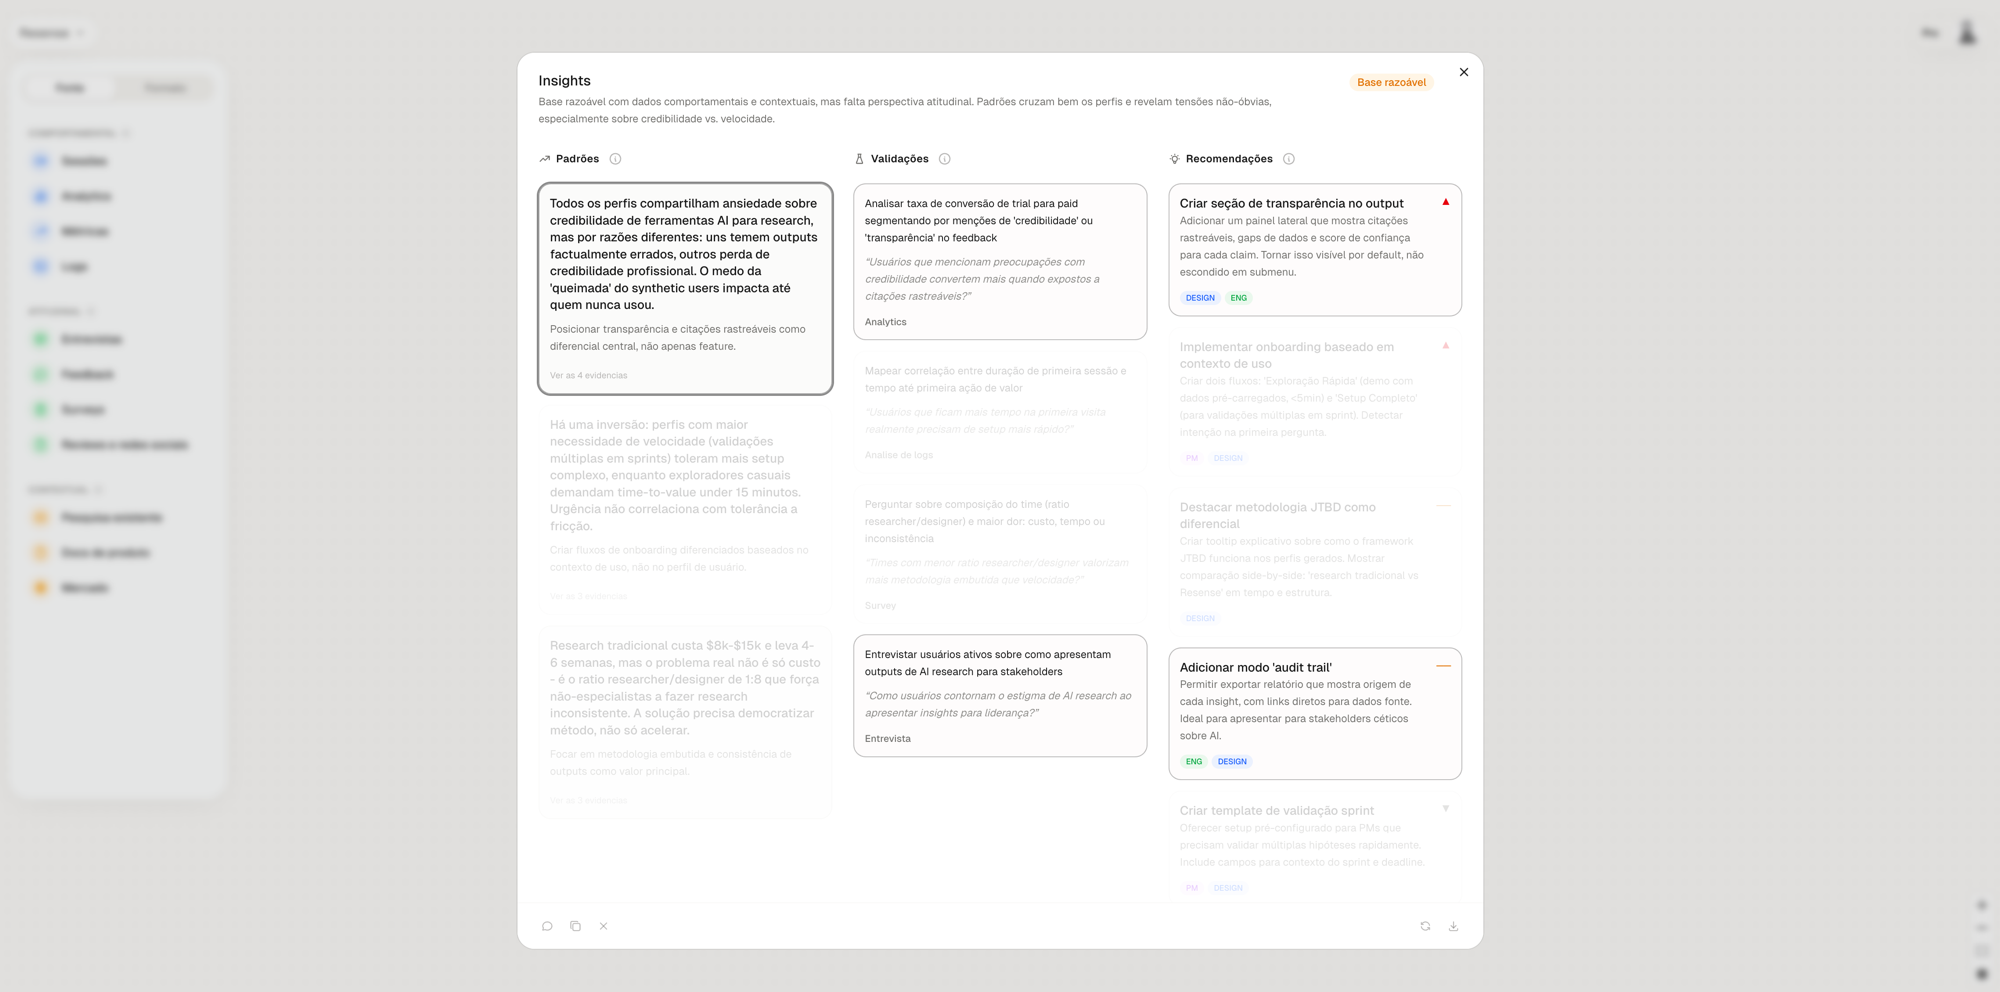
Avaliação e melhorias ficam fora do caminho crítico, disparadas sob demanda. A chamada ao modelo para perfis fecha, aí o usuário dispara uma chamada separada para padrões e recomendações quando precisar. Dois segundos sob demanda mantém o loop principal rápido, que é onde o time passa a maior parte do tempo.
O modo de falha
Quando o modelo não tem dados suficientes para gerar um Synthetic User confiável, ele diz isso. Eu construí um painel DataHint que exibe três sinais: uma análise do que está faltando, os tipos de dados necessários e uma pergunta de pesquisa sugerida pra ir buscar. O painel usa progressive disclosure. A análise fica visível por padrão. As lacunas e a pergunta sugerida expandem na interação.
Eu decidi que mostrar um Synthetic User ruim, sem sinais de incerteza, era mais perigoso do que ser honesto sobre a falta de dados. Times que confiam em pesquisa ruim tomam decisões piores, e era exatamente isso que eu queria que o produto ajudasse a evitar.
Antes de qualquer dado chegar ao LLM, um anonimizador remove PII: emails, CPFs, telefones, endereços IP e nomes em contexto. O modelo recebe apenas texto anonimizado. Dados em repouso usam criptografia em nível de campo. Eu não tenho acesso ao conteúdo bruto dos usuários. Isso custa conveniência de administração. Valeu a pena.
How I work with AI
O Resense não começou como produto. Começou como o meu próprio processo. Synthetic Users são como eu chego numa primeira leitura para quem eu estou desenhando em horas em vez de semanas, e aí eu valido os que importam com pessoas reais. Eu uso como ponto de partida, não para substituir a pesquisa.
O mesmo instinto atravessa o resto do meu trabalho. Eu prototipo fluxos navegáveis no Claude Code e no Cursor, então a engenharia recebe algo que dá pra clicar em vez de uma tela estática, que é onde o handoff costuma quebrar. E construí um agente de design que carrega os meus princípios de design e um conjunto de Synthetic Users como contexto, rodando testes de conceito e usabilidade contra eles antes de eu sentar com um usuário real. Quando comparei os vereditos dele com sessões reais, ficaram próximos o suficiente pra confiar como primeira passada.
IA não é uma etapa que eu grudo no final. Ela está na pesquisa, no protótipo e no teste, pra eu gastar meu tempo nas decisões e não no setup.
O que vem a seguir
Eu quero Synthetic Users que evoluam sozinhos conforme novos dados chegam, sem regeneração manual. E um agente de pesquisa que aprenda com sinais de correção e sugira o que validar a seguir com base nos gaps que já foram sinalizados. O objetivo é um sistema que fica mais útil quanto mais o time usa.
próxima leitura
Coisas.space →Coisas.space é um produto que usa IA pra categorizar cada link salvo e deixar você conversar com o que já guardou, pra realmente aprender com aquilo. O matching é semântico: pedir sobre React traz links que nem mencionam React no título. Eu usei IA em todo o processo, da pesquisa à ideação e aos testes.